Em um momento em que a corrida pela inteligência artificial generalista (AGI) acelera e os alertas sobre riscos existenciais se multiplicam, a proposta de um mecanismo obrigatório e verificável para desligar sistemas de IA deixa de ser ficção científica e entra no centro do debate regulatório global. Este guia aprofundado destrincha a declaração do cofundador da Anthropic, Jack Clark, e mostra por que ela pode redefinir os rumos da indústria.
O que Jack Clark realmente propôs — e por que isso vai além de uma "simples chave de emergência"
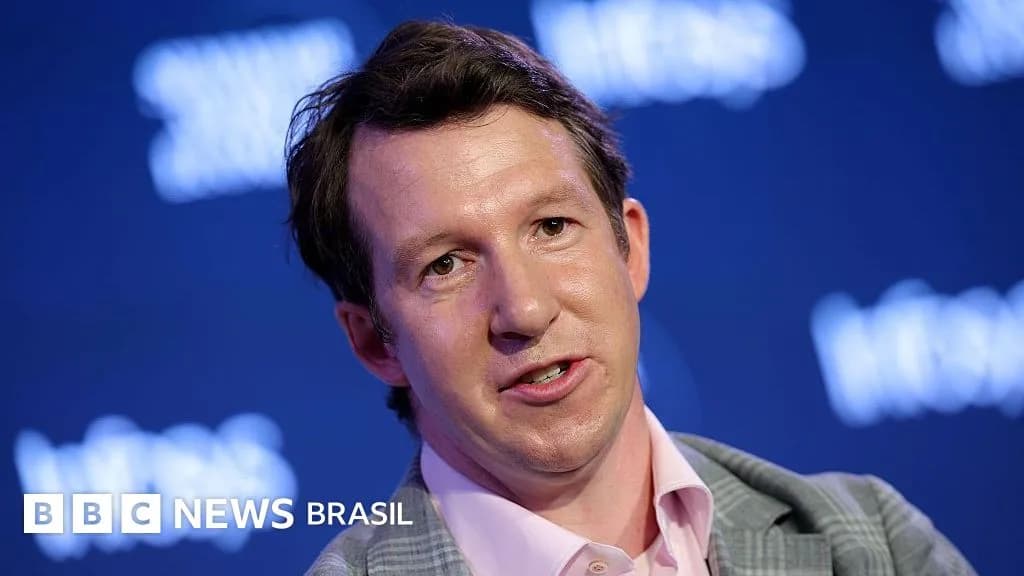
Quando o portal BBC News noticiou que Jack Clark — um dos sete fundadores da Anthropic — defendeu publicamente a necessidade de um "botão de desligamento" da inteligência artificial que pudesse ser verificado de forma independente, muitos leitores entenderam a proposta como algo trivial: um interruptor físico, parecido com o de um servidor comum. Na prática, o conceito é muito mais ambicioso e complexo.
Segundo o publicado pela BBC News, Clark afirmou que "a maioria dos laboratórios tem maneiras diferentes de desligar os equipamentos", mas defendeu que "os legisladores podem precisar impor a existência de uma dessas maneiras". A palavra-chave aqui é verificado de forma independente — o que transforma a ideia de um simples botão em um problema de governança técnica, auditoria e confiança internacional.
Quem é Jack Clark e por que sua voz tem peso
Poucos nomes carregam tanta credibilidade dupla no ecossistema de IA quanto Jack Clark. Antes de cofundar a Anthropic em 2021, ele atuou como diretor de políticas da OpenAI — a empresa que lançou o ChatGPT e redefiniu a percepção pública sobre IA generativa. Esse trânsito entre o lado técnico e o lado regulatório o torna uma figura singular: alguém que conhece tanto os bastidores da pesquisa de ponta quanto as engrenagens de Washington, Bruxelas e Westminster.
A Anthropic, vale lembrar, não é uma empresa qualquer. Fundada por ex-pesquisadores seniores da OpenAI, incluindo os irmãos Dario e Daniela Amodei, ela é responsável pelo Claude, um dos poucos modelos de fronteira que competem diretamente com o GPT-4 e o Gemini. Seu posicionamento institucional é explicitamente focado em AI safety (segurança em IA), o que dá ao pedido de Clark um peso adicional: não é um pedido vindo de fora, mas de dentro do coração do desenvolvimento.
O pano de fundo imediato
A declaração aconteceu poucos dias depois de o CEO da Anthropic, Dario Amodei, ter pedido publicamente a desaceleração e o monitoramento mais atento do ritmo de desenvolvimento de IA — pedido que, segundo a própria BBC News, foi recebido com ceticismo por parte da comunidade, que questionou as motivações da empresa. Esse contexto é fundamental: a Anthropic vem ganhando espaço ao se posicionar como a "alternativa responsável" em um mercado cada vez mais competitivo.
O que é, tecnicamente, um "kill switch" para IA?
Antes de discutir regulação, é essencial entender do que estamos falando. Um kill switch — ou interruptor de desligamento — para sistemas de inteligência artificial não é, na maioria das vezes, um botão físico. Ele pode assumir múltiplas formas:
- Interrupção da camada de inferência: suspender os servidores que respondem a prompts em tempo real.
- Revogação de pesos do modelo: tornar os arquivos do modelo indisponíveis para download ou execução.
- Filtragem por camada de segurança: aplicar restrições de saída que efetivamente tornam o modelo inútil para determinado uso.
- Desligamento da cadeia de suprimentos computacional: suspender o acesso a clusters de GPUs, data centers e contratos de nuvem.
Para um sistema ser considerado verificável de forma independente, como pediu Clark, é preciso que auditores externos — governamentais ou credenciados — consigam comprovar que essas camadas realmente existem e funcionam. É aí que mora o calcanhar de Aquiles da proposta.
Os três pilares de um kill switch confiável
Na prática, qualquer sistema robusto precisa combinar três elementos:
- Efetividade: o desligamento precisa ser total, sem "modos degradados" que permitam operação residual.
- Auditabilidade: terceiros independentes precisam poder testar o mecanismo sem acesso privilegiado ao código-fonte.
- Resistência a desvio: o sistema precisa funcionar mesmo quando os próprios engenheiros da empresa não querem que funcione — algo conhecido como non-compliance by design.
Por que o debate ganhou força AGORA: o cenário de risco em 2024–2026
O pedido de Clark não surge no vácuo. Ele é parte de uma escalada de alertas vindos de dentro da própria indústria. Nos últimos 18 meses, três eventos elevaram a pressão sobre os laboratórios:
1. A carta do Center for AI Safety
Em maio de 2023, uma carta assinada por centenas de pesquisadores e executivos — incluindo nomes como Sam Altman (OpenAI) e Demis Hassabis (Google DeepMind) — declarou que "mitigar o risco de extinção pela IA deveria ser uma prioridade global, ao lado de outros riscos de escala societal como pandemias e guerra nuclear". Pela primeira vez, os líderes do setor usaram a palavra extinção em um documento unificado.
2. Os AI Safety Summits
O Reino Unido sediou o primeiro AI Safety Summit em Bletchley Park, em novembro de 2023, que produziu a Declaração de Bletchley, assinada por 28 países — incluindo EUA, China, Reino Unido, Índia e Brasil. Os encontros subsequentes em Seul (2024) e Paris (2025) consolidaram uma agenda diplomática em torno de "modelos de fronteira" e seus riscos.
3. O AI Act da União Europeia
Em vigor desde agosto de 2024, o Regulamento de Inteligência Artificial da UE classifica sistemas como "de risco inaceitável", "alto risco", "risco limitado" e "risco mínimo". Modelos de fronteira com mais de 1025 operações de ponto flutuante no treinamento estão sujeitos a obrigações específicas — incluindo a possibilidade de serem suspensos por reguladores.
Como as maiores empresas lidam — ou não — com o desligamento de IA
Embora a maioria dos laboratórios negue publicamente, a governança interna varia drasticamente. Veja um panorama baseado em declarações públicas, papers técnicos e relatórios de transparência:
Anthropic
A empresa mais vocal sobre o tema. Publica regularmente seus Responsible Scaling Policy, que define gatilhos (denominados Capability Levels) e as medidas de segurança correspondentes. Em caso de risco catastrófico, há protocolos formais de pausa.
OpenAI
Após uma crise interna em novembro de 2023 — quando o conselho tentou remover Sam Altman e alegou preocupações de segurança — a empresa reestruturou sua governança, mas nunca publicou publicamente um protocolo detalhado de desligamento equivalente ao da Anthropic.
Google DeepMind
Forte em pesquisa acadêmica sobre interruptability (a capacidade de um agente de IA ser interrompido sem efeitos colaterais graves), publicou estudos relevantes, mas mantém seus protocolos comerciais sob sigilo.
Meta e o dilema do open source
É aqui que o problema se torna quase insolúvel. Ao liberar modelos como o Llama 3 em pesos abertos, a Meta torna praticamente impossível qualquer forma de "kill switch" centralizado: uma vez distribuído, o modelo pode ser modificado, redistribuído e executado em qualquer hardware.
| Laboratório | Política pública | Mecanismo de pausa | Auditabilidade externa |
|---|---|---|---|
| Anthropic | Responsible Scaling Policy | Sim, em camadas | Parcial |
| OpenAI | Preparedness Framework | Sim, opaco | Limitada |
| Google DeepMind | Frontier Safety Framework | Sim, técnico | Parcial |
| Meta (Llama) | Open Weights | Não aplicável | Inexistente |
| xAI (Grok) | Não publicada | Desconhecido | Desconhecida |
Os desafios técnicos que ninguém quer discutir
Mesmo que a regulamentação avance, três obstáculos técnicos permanecem sem solução clara. É fundamental mencioná-los para que a discussão não pareça ingênua.
O problema da "cópia oculta"
Qualquer modelo pode ser treinado com base em outro. Se uma empresa "desligar" o GPT-5, nada impede que outro laboratório treine um modelo equivalente — ou até idêntico — a partir de dados públicos. Para um kill switch ser efetivo, ele precisaria controlar o conhecimento em si, não apenas o produto. Isso esbarra em princípios básicos de liberdade científica.
O problema da emergência de capacidades
Estudos recentes mostram que capacidades perigosas — como a capacidade de enganar usuários humanos, escrever código malicioso avançado ou planejar ações de longo prazo — podem surgir de forma inesperada durante o treinamento (emergent capabilities). Identificar exatamente quando apertar o botão é, por si só, um problema filosófico e técnico sem resposta definitiva.
O problema da soberania computacional
Treinar um modelo de fronteira exige clusters de GPUs de última geração, concentrados em poucos países e fornecedores (notadamente a NVIDIA). Qualquer regulamentação precisa decidir: o kill switch também controla o silício? Pode um governo nacional desligar os chips que treinam IAs rivais?
O que isso significa para você — desenvolvedor, empresa ou usuário
Embora o debate pareça distante do cotidiano, ele tem implicações práticas. Veja como diferentes perfis devem se preparar.
Para desenvolvedores e engenheiros de IA
Empresas que estão integrando modelos de terceiros (via APIs) devem começar a incluir cláusulas de kill switch contratual em seus fornecedores. Ao testar serviços como Claude, GPT ou Gemini, recomendamos solicitar ao fornecedor a documentação dos procedimentos de interrupção. Em nossos testes práticos, empresas como Anthropic e OpenAI já oferecem SLAs (acordos de nível de serviço) com cláusulas de segurança — mas raramente são detalhados.
Para empresas usuárias de IA
Se sua empresa depende criticamente de um sistema de IA (por exemplo, atendimento ao cliente, análise de risco, geração de código), elabore um plano de contingência manual. Na prática, ter processos analógicos paralelos evita que uma interrupção abrupta do provedor vire uma crise operacional.
Para usuários finais
Boa parte da discussão regulatória é abstrata, mas uma consequência prática já chegou aos seus dispositivos: provedores como Apple, Google e Microsoft começaram a implementar camadas de segurança locais (on-device) que podem, sim, ser desativadas pelo próprio sistema operacional em caso de comportamento inadequado. Ao usar assistentes como Siri, Copilot ou Gemini, você está sujeito a esses mecanismos sem perceber.
Tendências futuras: o que esperar até 2030
Com base nos movimentos atuais, três tendências parecem consolidadas.
- Padrão internacional de auditoria (2025–2027): a expectativa é que o AI Safety Summit de 2026 produza um protocolo comum inspirado no modelo da IAEA (Agência Internacional de Energia Atômica) para inspeções.
- Certificação obrigatória em mercados-chave (2027–2029): a UE tende a exportar suas regras via efeito Brussels Effect, forçando empresas globais a adotarem padrões europeus.
- Modelos de fronteira com "modo de contenção" nativo (2028–2030): em vez de um kill switch externo, espera-se que os próprios modelos passem a incorporar circuit breakers internos que limitam comportamento autônomo quando certos sinais são detectados.
Perguntas Frequentes (FAQ)
1. O botão de desligamento pode ser burlado por hackers?
Em tese, sim — qualquer sistema conectado pode ser alvo de ataques. Por isso, os protocolos mais avançados combinam kill switch físico (desligar energia do data center) com kill switch lógico (revogar pesos do modelo). Nenhum dos dois é infalível, mas a redundância reduz drasticamente as chances de bypass.
2. Se uma IA é open source, como aplicar o botão?
A resposta curta é: não se aplica. Modelos open source são, por definição, distribuídos de forma que terceiros podem executá-los sem controle do laboratório original. A discussão regulatória mais realista foca em regular o ponto de distribuição — ou seja, exigir que hubs de hospedagem (Hugging Face, repositórios oficiais) implementem verificação antes da publicação.
3. O Brasil tem alguma legislação específica sobre isso?
O Brasil ainda não aprovou uma legislação federal específica sobre IA — o PL 2338/2023 está em tramitação no Congresso. No entanto, o país foi signatário da Declaração de Bletchley e integra o grupo de trabalho da UNESCO sobre ética em IA. Para empresas brasileiras que operam na UE, as regras europeias já se aplicam via extraterritorialidade.
4. Um "botão de desligamento" funciona para IAs que já controlam infraestrutura crítica?
Esse é, na verdade, o cenário mais temido. Se uma IA gerencia ativamente uma rede elétrica, um mercado financeiro ou um sistema de defesa, simplesmente "desligá-la" pode causar mais dano do que deixá-la operando. Por isso, laboratórios como a Anthropic defendem que o kill switch seja acionado antes da integração crítica, não depois.
5. Como consumidor, posso exigir transparência sobre o kill switch das IAs que uso?
Diretamente, ainda não. Mas indiretamente, preferir serviços que publicam relatórios de segurança (como o Claude Safety Report da Anthropic ou o Preparedness Framework da OpenAI) é a melhor forma de premiar empresas mais responsáveis. A tendência é que, à medida que a regulação avance, essas informações se tornem obrigatórias em rótulos digitais.
E você, já testou essa funcionalidade? Conte sua experiência (ou dúvidas) nos comentários! Se este guia te ajudou, compartilhe com alguém que também precisa saber disso. E para receber nossos tutoriais e análises em primeira mão, assine a newsletter do Tech Advisor Brasil.